Savez-vous ce qui, dans vos habitudes, oblige l'IA à tout réécrire ?
Une pause de plus d'une heure, un changement de modèle en pleine tâche : ce sont les moments qui coûtent.
Un token, c'est le morceau de texte que l'IA lit ou écrit, et c'est lui que l'on compte quand votre limite tombe. Le prix du token baisse, la facture des entreprises monte. C'est notre hypothèse : une bonne part se joue dans nos habitudes, dans ce que l'IA relit à chaque message. Ce carnet rassemble ce qui est mesuré, ce que disent les éditeurs et les gestes qui changent quelque chose.
Chez les clients d'une plateforme d'API, AI.cc, le coût moyen du million de tokens a baissé de 67 % en un an, et des entreprises comme Uber ou Tesla plafonnent pourtant la dépense de leurs salariés.
Dans Claude, la longueur de la conversation en cours compte dans vos limites ; dans un agent de code, chaque action fait relire tout ce qui précède, même pour une question d'une ligne.
Une relecture en cache coûte 5 % du prix normal sur Opus 5.5 et Sonnet 5.5 ; au token, ce qui coûte, c'est d'écrire dans le cache, jusqu'au double du prix normal, et surtout les moments où tout doit être réécrit.
Une fois le cache expiré, toute la conversation se relit au plein tarif : dans claude.ai, le premier message après une longue pause recompte en entier le contenu d'un projet.
Les outils annoncés pour faire économiser rapportent peu, et parfois font payer plus.
Une nouvelle conversation pour un nouveau sujet, des instructions courtes, le bon modèle choisi au départ, une session finie plutôt que reprise le lendemain.
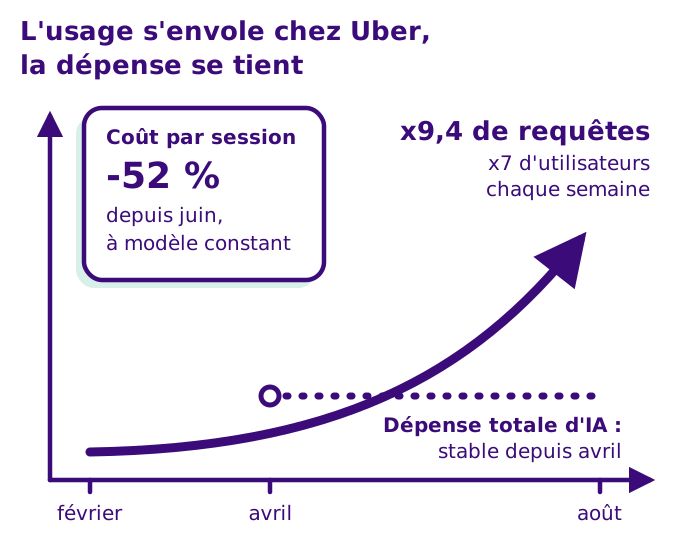
Le prix de chaque token baisse, mais les usages en consomment beaucoup plus, surtout avec les outils qui enchaînent les tâches tout seuls. Les entreprises posent des plafonds. Uber montre pourtant qu'une dépense peut se tenir pendant que l'usage explose, par des réglages posés pour tous et un suivi de la dépense en temps réel.
Le carnet voisin, « Pourquoi la facture de l'IA monte-t-elle alors que son prix baisse ? », traite ce versant du point de vue de l'entreprise. Nous en rappelons l'essentiel.
Le même Uber raconte la suite sur son blog d'ingénierie, le 27/08/2026. De février à août, le nombre de salariés qui utilisent ses agents chaque semaine a été multiplié par 7 et le nombre de requêtes par 9,4, alors que la dépense totale s'est à peu près stabilisée depuis avril. À modèle constant, le coût par session a baissé de 52 % depuis son pic de juin (Uber).
Les leviers qu'Uber cite sont des réglages posés pour tous : une compaction automatique de la conversation dès 400 000 tokens, un niveau de réflexion moyen par défaut, le modèle choisi selon la tâche, le cache, les outils chargés à la demande, et un suivi de la dépense en temps réel, avec des alertes à 50, 80 et 100 % de la dépense prévue et des paliers validés par le manager. Ce sont des chiffres qu'Uber publie sur ses propres outils. Ces réglages agissent sur ce que relit chaque session, et c'est cet étage que ce carnet regarde, du côté de celui qui travaille avec l'IA.
Un token est un morceau de mot, l'unité que le modèle lit et écrit. Sur un abonnement, vous ne voyez jamais de facture : vous voyez une limite qui tombe. Elle tombe plus vite quand la conversation s'allonge, quand on joint de gros fichiers et quand on demande plus de réflexion.
Le modèle lit des tokens : des morceaux de mots, de ponctuation ou de code. Tout ce qu'il reçoit et tout ce qu'il écrit se compte ainsi : votre message, mais aussi les instructions qui l'accompagnent, les fichiers joints, l'historique de la conversation et sa réponse. Avec une clé d'API, ces tokens se paient au million. Sur un abonnement, ils se convertissent en limites : une fenêtre de quelques heures, une limite de la semaine.
L'aide de Claude, mise à jour le 22/09/2026, liste ce qui pèse sur les limites d'usage : la longueur de vos messages, la taille des fichiers joints, la longueur de la conversation en cours, les outils comme la recherche web, le modèle choisi et le niveau d'effort (Claude Help Center).
OpenAI en dit moins. L'offre ChatGPT Plus peut comporter des plafonds de messages, surtout en période de forte demande, qui varient selon l'état du système (OpenAI). OpenAI ne dit pas ce qu'une longue conversation retire des plafonds. Un signe montre pourtant que la longueur compte : depuis l'été 2026, un texte de plus de 10 000 caractères collé dans ChatGPT devient automatiquement une pièce jointe, pour ne pas occuper toute la fenêtre de contexte, la mémoire de travail du modèle (notes de version de ChatGPT).
La même question peut donc coûter peu au début d'une conversation et beaucoup au bout de deux heures. Le message est identique, ce qui change, c'est tout ce que le modèle doit relire avec lui. C'est le mécanisme qu'il faut comprendre pour consommer moins.
Dans ce que l'IA relit. Le modèle ne garde rien d'un message à l'autre, alors l'outil lui renvoie toute la conversation à chaque fois. Dans un agent qui enchaîne les actions, chaque action est une nouvelle requête, et la relecture finit par peser presque tout le volume.
Un modèle ne se souvient de rien entre deux requêtes. Pour qu'il suive la conversation, l'outil lui renvoie à chaque message ses instructions, le contexte du projet et tout l'historique. La documentation de Claude Code le dit sans détour : chaque requête renvoie toute la conversation, et une question d'une ligne dans une session ouverte toute la journée fait relire toute la journée (documentation de Claude Code).
Dans un agent, l'effet se multiplie. Un agent est une IA qui agit : elle lit des fichiers, lance des commandes, consulte des pages. Chaque action envoie une nouvelle requête qui relit tout ce qui précède, résultats des actions compris.
La documentation de Claude Code donne l'exemple d'une session : 1 200 tokens d'entrée nouveaux, 5 300 tokens produits, 50 000 écrits dans le cache et 940 000 relus depuis le cache, pour environ 0,55 dollar au prix catalogue (documentation de Claude Code). Presque tout le volume est de la relecture.
À l'échelle d'une plateforme, la proportion est la même. Chez OpenRouter, qui donne accès à des centaines de modèles par une seule interface, un peu moins de 90 % des tokens consommés par des agents en septembre 2026 étaient des relectures en cache, contre environ 60 % en janvier (OpenRouter). Fin septembre, les agents y consommaient environ 7 fois plus de tokens que les humains.
Un agent de code envoie aussi des instructions de départ. Systima a mesuré en juillet 2026 qu'avant même la question, Claude Code envoyait environ 33 000 tokens d'instructions et de définitions d'outils, contre environ 7 000 pour un outil concurrent, OpenCode (Systima). Cette part se relit, elle aussi, à chaque message.
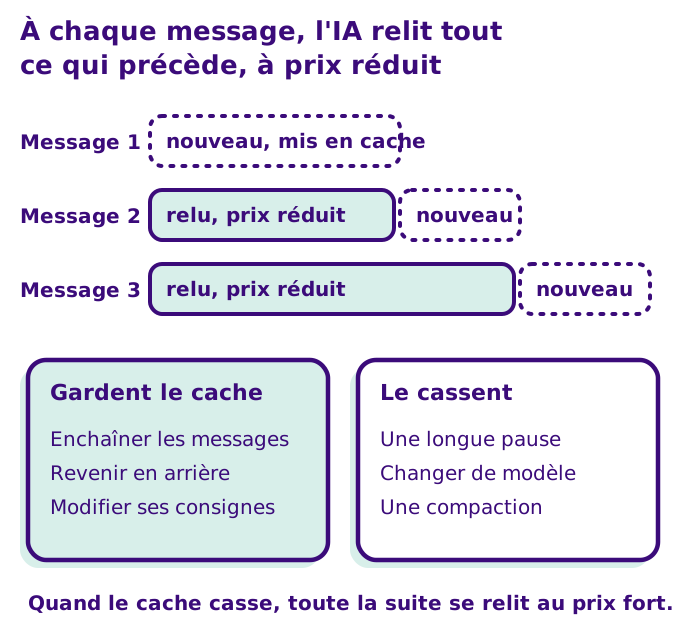
Parce que la relecture se paie au tarif réduit du cache tant qu'il tient, et au plein tarif quand il faut le réécrire. Une pause plus longue que la vie du cache ou un changement de modèle obligent à tout réécrire. C'est là que la facture grimpe.
Le cache garde en mémoire le début de la conversation pour éviter de tout traiter de nouveau. Sur les modèles actuels d'Anthropic, une lecture en cache coûte 5 % du prix d'entrée sur Opus 5.5 et Sonnet 5.5, 2,5 % sur Fable 5.1 et Mythos 5.1, et 10 % sur les autres modèles. Écrire dans le cache coûte en revanche 1,25 fois le prix normal pour un cache de cinq minutes, et 2 fois pour un cache d'une heure (grille d'Anthropic).
Le cache ne sert que si le début de la requête est exactement le même. Chaque modèle a son propre cache : changer de modèle en cours de conversation fait relire toute la conversation sans remise. Thariq Shihipar, chez Anthropic, donne l'exemple d'une conversation de 100 000 tokens sur Opus, où passer au modèle léger Haiku coûterait plus cher que de rester sur Opus (blog d'Anthropic).
Le cache expire. Sur un abonnement, la conversation principale de Claude Code reçoit un cache d'une heure, et le reste (sous-agents, compaction) cinq minutes ; avec une clé d'API, tout est à cinq minutes par défaut (documentation de Claude Code). Dans claude.ai, le contenu d'un projet est mis en cache et compte moins quand il sert de nouveau, mais l'aide prévient : au retour après une longue pause, le premier message compte de nouveau ce contenu en entier (Claude Help Center).
Boris Cherny, qui a créé Claude Code, le résumait en avril 2026 : laisser son ordinateur plus d'une heure se solde souvent par un raté complet du cache, et ces ratés coûtent cher sur une fenêtre d'un million de tokens (The Register).
La durée de vie du cache a bougé en 2026. Selon le ticket d'un abonné relayé par The Register, Anthropic a introduit un cache d'une heure vers le 1er février, puis est revenu à cinq minutes vers le 7 mars pour beaucoup de requêtes ; des abonnés ont alors vu leurs limites tomber plus vite. Zivtech a calculé en avril que, sur une session Opus 4.6 de 100 000 tokens, un tour coûtait environ 12,5 fois plus cher une fois le cache expiré (Zivtech). C'est un calcul sur les prix de l'époque : l'article ne mesure aucune session réelle.
Les plus utiles ne coûtent rien. En conversation, un nouveau sujet dans une nouvelle conversation et les documents de référence dans un projet. Dans un agent, repartir à zéro entre deux tâches, finir une session plutôt que la reprendre, et choisir le modèle au départ.
L'aide de Claude donne des conseils simples (Claude Help Center) :
Le mécanisme de la partie 3 en tire un geste de plus : un nouveau sujet mérite une nouvelle conversation. Une conversation qui traîne depuis le matin fait relire tout ce qui précède à chaque nouvelle question, même sans rapport.
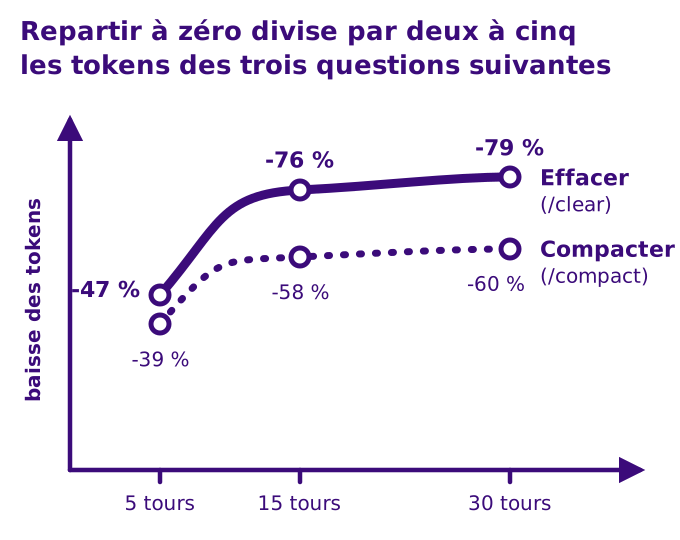
Anthropic recommande d'effacer la conversation (/clear) entre deux tâches sans lien, et, après deux corrections ratées sur le même problème, de repartir avec une meilleure consigne plutôt que d'en tenter une troisième ; effacer ne coûte rien (bonnes pratiques d'Anthropic).
Un praticien l'a mesuré dans une campagne de 945 exécutions publiées avec leurs données, en octobre 2026, sur des questions de lecture de code, avec trois conversations par longueur testée, en tokens et non en dollars (dépôt de kenseii1) :
Reprendre une longue conversation après une pause plus longue que la vie du cache fait tout relire au plein tarif (partie 4). Compacter une session reprise coûte cher aussi, puisque la compaction relit toute la conversation au plein tarif une fois le cache expiré ; Anthropic conseille de compacter à une pause naturelle, entre deux tâches (documentation de Claude Code). Une note de fin de session, d'où l'on repart le lendemain dans une conversation neuve, évite les deux.
Claude Code s'y met aussi : après environ 54 minutes d'inactivité, il compacte de lui-même une conversation de plus de 200 000 tokens avant que son cache d'une heure n'expire (documentation de Claude Code).
Changer de modèle en route casse le cache. La bonne règle devient donc de choisir le modèle et le niveau de réflexion au début de la tâche. Le test des 945 exécutions trouve qu'un effort bas sur Opus 5.5 économise 17 % de tokens sans perte de justesse sur ses questions, alors qu'un effort haut sur Sonnet 5.5 en ajoute 20 % pour les mêmes réponses justes.
Tout ce qui est chargé à chaque message, instructions du projet, outils, sous-agents. Des instructions courtes et des procédures rangées à part allègent chaque tour. Les sous-agents isolent le travail, mais ils relisent leurs propres instructions et ne font pas toujours économiser.
Les instructions d'un projet (le fichier CLAUDE.md pour Claude Code, les instructions d'un projet dans claude.ai ou ChatGPT) sont relues à chaque message. La documentation de Claude Code conseille de rester sous 200 lignes par fichier (documentation de Claude Code). Le test des 945 exécutions chiffre l'enjeu : 16 Ko de règles sans rapport avec la tâche ajoutent 46 % de tokens par question, et les mêmes règles rangées dans une compétence (une skill, chargée seulement quand on l'appelle) coûtent 31 % de moins.
Les définitions des outils se chargent aussi. L'écart entre un serveur MCP (le protocole qui branche un outil externe sur l'IA) et une simple ligne de commande s'est réduit depuis que Claude Code ne charge les outils qu'à la demande : sur une tâche menée trois fois, Checkly mesure 48 000 à 50 000 tokens avec le serveur, 45 000 à 48 000 avec la ligne de commande (Checkly, juillet 2026). Le test des 945 exécutions ne trouve pas d'effet établi à couper les serveurs inutiles.
Un sous-agent part avec son propre contexte et ne rend qu'un résumé : la conversation principale reste plus légère. Mais il relit lui-même ses instructions à chaque tour. Systima mesure une tâche qui coûte 121 000 tokens faite directement et 513 000 tokens répartie sur deux sous-agents, environ 4 fois plus (Systima). Le test des 945 exécutions ne trouve pas d'effet net, dans un sens ni dans l'autre.
Les équipes d'agents, où plusieurs agents travaillent ensemble, consomment environ 7 fois plus de tokens qu'une session seule quand chacun tourne en mode plan, selon Anthropic (documentation de Claude Code).
Le mécanisme vaut ailleurs. Codex, l'agent de code d'OpenAI, compte en crédits par million de tokens d'entrée, d'entrée en cache et de sortie ; l'entrée en cache y coûte 5 à 10 % de l'entrée normale selon le modèle, sans frais d'écriture dans le cache, et l'offre Plus a des fenêtres de cinq heures (tarifs de Codex). Cursor ajoute aux offres d'équipe 0,25 dollar par million de tokens vers les modèles tiers, cache compris (aide de Cursor). Copilot facture au token depuis juin.
La facture d'une équipe additionne les habitudes de chacun. Avant de poser un plafond, une équipe gagne à savoir où part sa consommation, ce que les outils mesurent déjà, et à partager des instructions et des réglages courts, qui pèsent sur chaque message de chacun.
Selon Anthropic, sur ses déploiements en entreprise, Claude Code coûte en moyenne environ 13 dollars par développeur et par jour actif, 150 à 250 dollars par mois, et moins de 30 dollars par jour actif pour 90 % des utilisateurs (documentation de Claude Code). Ce sont des moyennes de l'éditeur sur ses clients entreprise, en dollars : elles ne disent rien d'un abonnement individuel, où l'usage se compte en limites.
Un plafond par personne frappe tout le monde sans dire quelles conversations coûtent, ni pourquoi. Savoir quelles sessions coûtent, et pourquoi, vient avant le plafond. Les outils mesurent déjà : la commande /usage dans Claude Code, la page d'usage dans claude.ai, les tableaux de bord de Copilot et de Cursor.
Une équipe partage des instructions de projet, des compétences et des réglages. Ce sont eux qui pèsent sur chaque message de chacun : les garder courts et à jour profite à tous. Parmi les leviers d'Uber figurent ces réglages communs : compaction automatique à 400 000 tokens, effort moyen par défaut, modèle choisi par tâche.
Quand on compte les tokens plutôt que le coût, et quand l'économie se paie en temps. Les outils annoncés pour réduire les tokens rapportent peu, une compaction trop agressive fait perdre le fil, et les conseils vieillissent en quelques mois.
Deux mesures récentes vont contre l'intuition. Dans une prépublication de juillet 2026, Sarel Weinberger et Amir Hozez compressent les résultats que les outils renvoient au modèle dans Claude Code : la plus forte compression réduit de 38,4 % ces tokens et augmente le coût facturé de 6,8 % ; la baisse des tokens n'est que faiblement liée à celle du coût (arXiv).
JetBrains teste un à un les modules gratuits annoncés pour économiser. Sur 425 essais facturés, l'outil rtk, annoncé à 60 à 90 % d'économie, rend le travail 7,6 % plus cher en effort bas et ne change rien en effort haut, à qualité égale ; dans un premier volet, la compétence caveman, annoncée à -65 %, mesurait -8,5 % (JetBrains). L'explication tient au cache : rtk ne compresse qu'une petite part de ce que l'agent lit, la relecture en cache fait l'essentiel de la facture, et l'agent fait 13,8 % de tours en plus.
« Token reduction is not a reliable proxy for cost reduction in tool-heavy coding agents. »
Anthropic le reconnaît pour les sous-agents : un sous-agent neuf doit d'abord rassembler le contexte que la conversation avait déjà, et peut finir plus lent que la tâche faite sur place (bonnes pratiques d'Anthropic). Une compaction trop précoce peut faire perdre une contrainte ou la raison d'une décision, qu'il faut alors réexpliquer. Un modèle trop léger peut boucler et se corriger plusieurs fois. Une économie de tokens qui ajoute des allers-retours se paie en temps, et ce temps peut coûter plus que les tokens.
En 2026, la durée de vie du cache a changé deux fois en deux mois, le prix de la lecture en cache a baissé de moitié sur les derniers modèles, et le chargement des outils à la demande a rendu caduque une partie des comparaisons entre serveurs et lignes de commande. Un conseil sur les tokens sans date ni version est à revérifier.
Les sources mesurent des mécanismes et des cas isolés. Aucune ne dit quelle part de la facture d'une entreprise vient des habitudes de ses salariés, ni ce que coûte une compaction en qualité, ni ce qu'une longue conversation coûte dans ChatGPT, ni ce qu'un token économisé fait gagner en temps.
La plupart des chiffres viennent d'éditeurs qui vendent l'outil mesuré, d'entreprises qui mesurent leurs propres agents, ou de praticiens qui testent quelques cas. Ils datent tous de 2026, se comptent tantôt en dollars, tantôt en limites, et changent d'une version à l'autre.
Ces questions servent à repérer, dans vos habitudes et celles de votre équipe, les moments où l'IA réécrit tout. Notre position : mesurer et changer quelques gestes avant d'ajouter un outil ou de poser un plafond.
Une pause de plus d'une heure, un changement de modèle en pleine tâche : ce sont les moments qui coûtent.
Un nouveau sujet mérite une conversation neuve ; après deux corrections ratées, mieux vaut repartir d'une meilleure consigne.
Tout ce qui ne sert pas se relit quand même à chaque message.
Une note de fin de session évite de payer la relecture complète de la veille.
Une économie de tokens qui ajoute des allers-retours peut coûter plus qu'elle ne rapporte.
Ce carnet part d'une recherche du 24/10/2026 croisant trois moteurs (Perplexity, Perplexity Social, Gemini), vérifiée sur la documentation d'Anthropic et relue par deux relecteurs contradicteurs ; puis d'une collecte de quatre mois sur LinkedIn, Reddit, Hacker News, X, le web et YouTube (639 sources), triée par deux agents, dont les chiffres porteurs ont été rouverts un à un sur leur source. Chaque affirmation a été vérifiée sur la source citée, puis relue par deux relecteurs contradicteurs. Les mesures de praticiens publiées sur Reddit, que nous n'avons pas pu rouvrir, n'y sont pas citées. Édition du 27/10/2026.
Nous aidons les équipes à comprendre où part leur consommation et à installer les gestes et les réglages qui la font baisser, avant d'ajouter un outil ou un plafond.